datalab
Daten & Prozesse • Eigene ML-Plattform
Worum es geht
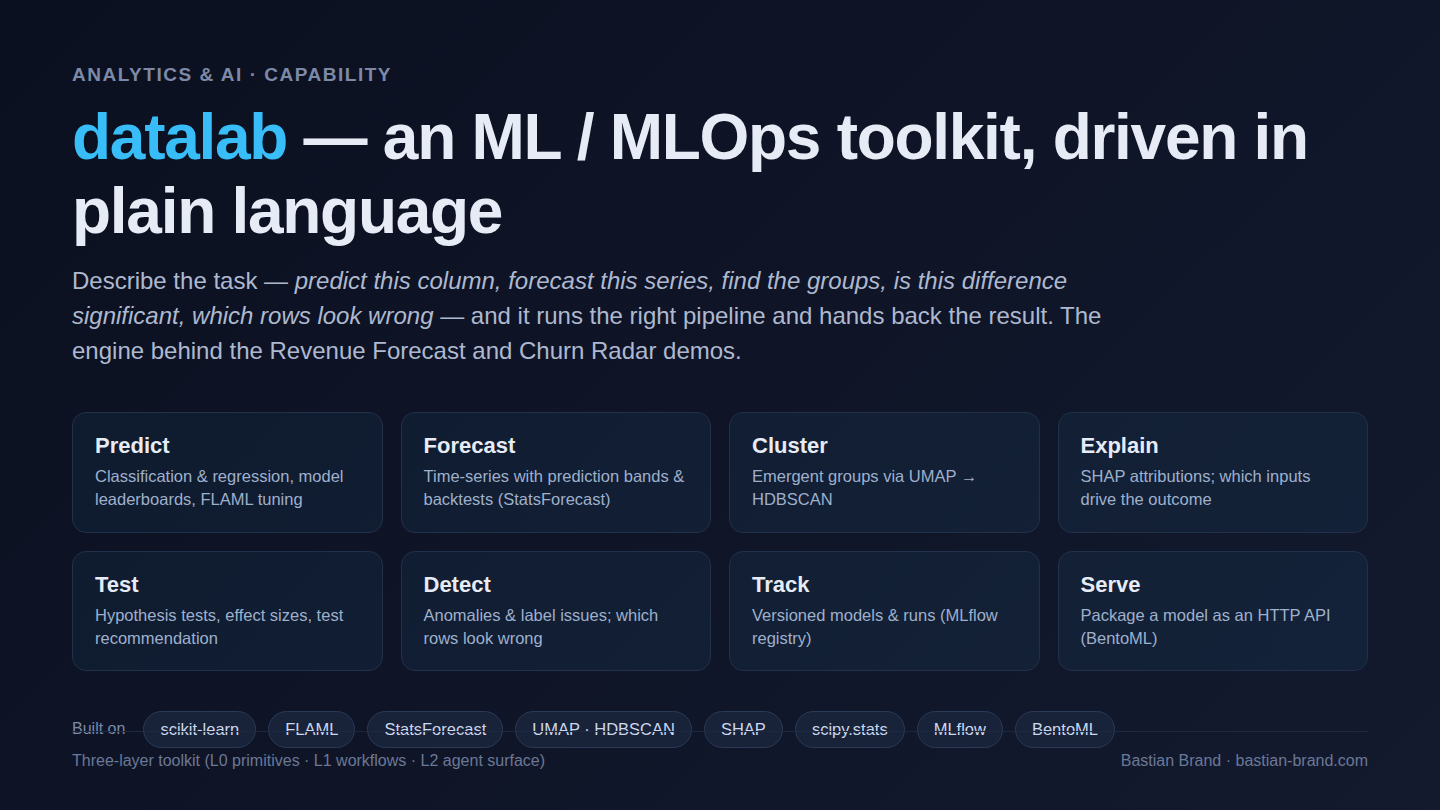
Der Werkzeugkasten hinter den anderen Analytik-Demos auf dieser Seite. Kein Einzelmodell, sondern eine wiederverwendbare Schicht für Machine Learning und MLOps, die man in normaler Sprache bedient: Aufgabe beschreiben — sage diese Spalte vorher, prognostiziere diese Reihe, finde die Gruppen, ist dieser Unterschied signifikant, welche Zeilen sehen falsch aus — und sie wählt die passende Verarbeitungskette, lässt sie laufen und gibt ein Ergebnis zurück, mit dem man arbeiten kann. Die Demos Revenue Forecast und Customer Churn Radar nutzen ihre Verarbeitungsketten für Prognose und Klassifikation.
Wie ich es gebaut habe
Ein Aufbau in drei Ebenen: einfache Bausteine (L0), zu Aufgaben-Abläufen gebündelt (L1), nach außen sichtbar über eine einzige Schnittstelle für den Agenten (L2). Darunter setzt sie die jeweils richtigen Werkzeuge zusammen — scikit-learn und FLAML für überwachtes Lernen und Feinjustierung, StatsForecast für Zeitreihen mit Prognosebändern, UMAP + HDBSCAN für Struktur ohne Zielgröße, SHAP für Erklärungen, scipy.stats für Inferenzstatistik — und behandelt Modelle als eigenständige Erzeugnisse: Jeder Lauf wird in MLflow protokolliert und versioniert, und jedes Modell lässt sich mit BentoML als HTTP-Schnittstelle ausliefern. Der Zweck ist Wiederholbarkeit: Derselbe Werkzeugkasten erzeugt die Prognose, das Abwanderungsmodell und dessen Erklärungen — die Analyse ist damit reproduzierbar statt jedes Mal handgestrickt.
Besonderheiten
- Ein Werkzeugkasten, viele Aufgaben — vorhersagen, prognostizieren, gruppieren, erklären, testen, Auffälligkeiten finden, ausliefern
- Modelle als versionierte Erzeugnisse (MLflow-Registry), auf Abruf betreibbar (BentoML)
- Die wiederverwendbare Maschine unter den anderen Demos, kein Wegwerf-Notebook
Stack
Python · scikit-learn · FLAML · StatsForecast · UMAP/HDBSCAN · SHAP · MLflow · BentoML